
 English
 Français
 Español
 Português (Brasil)
 Italiano
GEO-Optimierung in Deutschland 2026: Trends, Tools und die Lokalisierungslücke
 Danila Kadtsyn6 Min. Lesezeit17. November 2026
Das Wichtigste in Kürze
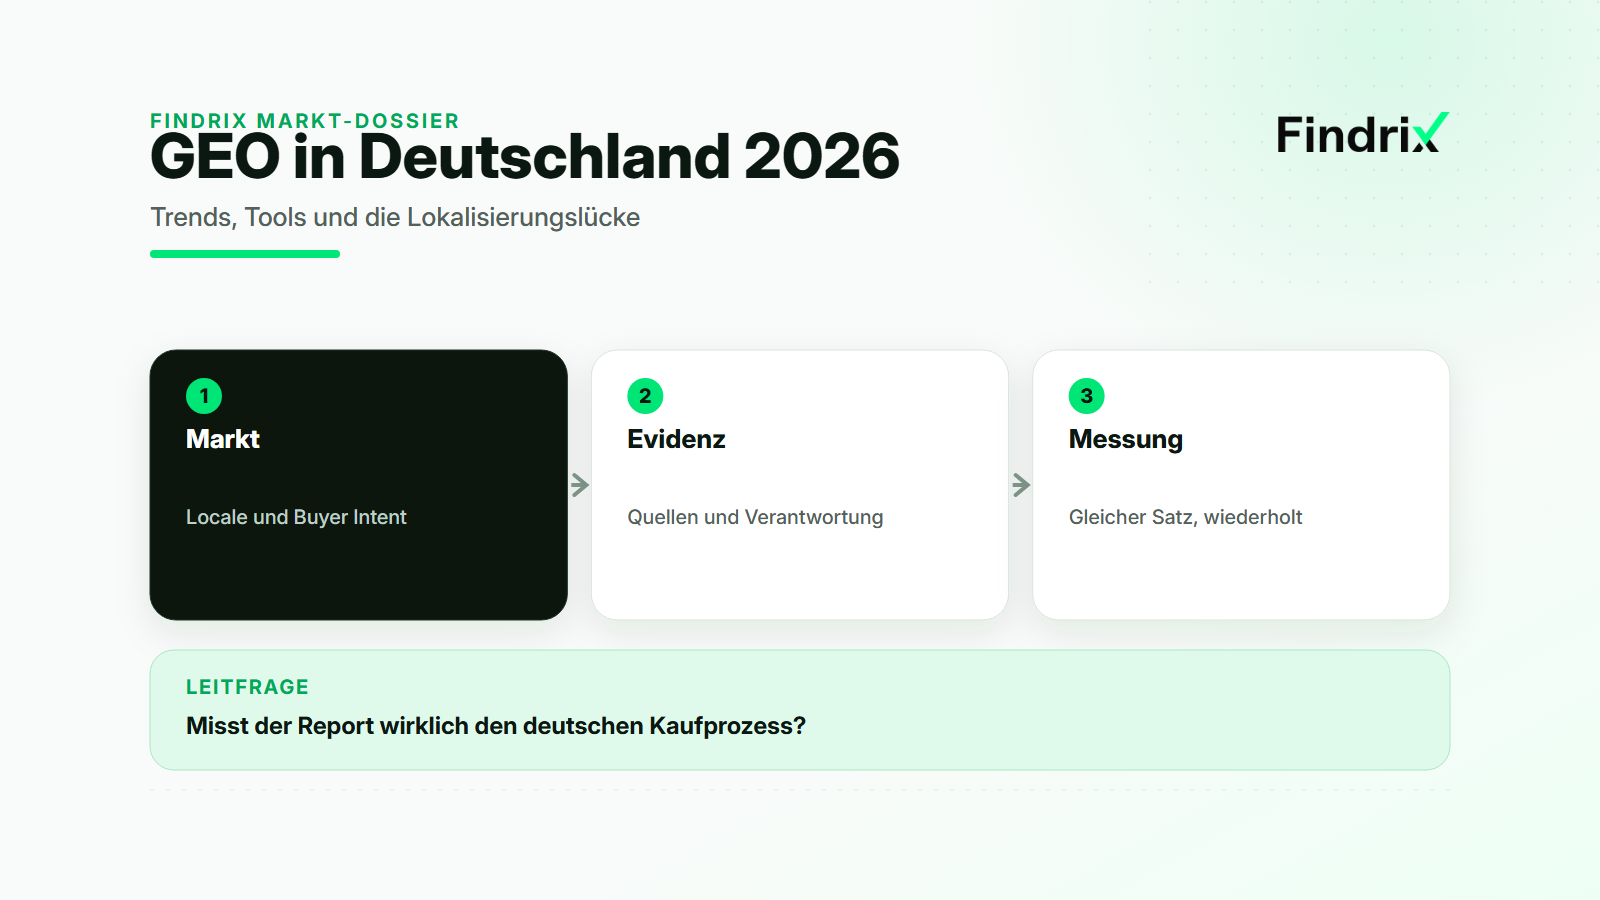
- Deutschsprachige Ausgaben beweisen keine Deutschland-spezifische Stichprobe.
- Rohantworten, Quellen und Wiederholungen sind belastbarer als ein einzelner Gesamtscore.
- Optimieren Sie in der Reihenfolge Fundament, verantwortbare Evidenz und wiederholte Messung.
TL;DR Ein AI-Visibility-Report ist nicht deshalb deutschlandspezifisch, weil seine Prompts auf Deutsch formuliert sind. Erst wenn Markt, Sprache, Buyer Intent, Wettbewerber, Engine-Region und Messzeitraum zusammenpassen, kann das Ergebnis deutsche GEO-Entscheidungen tragen.
Wenn ein Report seinen deutschen Prompt-Satz, die Wettbewerber, die Locale, die geprüften Engines und das Erhebungsdatum nicht ausweisen kann, ist er kein belastbarer Deutschland-Benchmark - auch wenn alle Antworten auf Deutsch vorliegen.
Die operative Bestandsaufnahme bei Findrix zeigt, warum diese Grenze wichtig ist: Am 15. November 2026 waren 188 aktive Nischen vorhanden, aber nur eine davon explizit als de-DE markiert; ein eingefrorener, repräsentativer de-DE-Radar-Build lag nicht vor. Diese Zahlen beschreiben den damaligen Findrix-Bestand, nicht den deutschen Markt. Gerade deshalb sind sie nützlich: Ein großer globaler Datenbestand macht einen dünnen lokalen Ausschnitt nicht automatisch repräsentativ.
Für deutsche Teams folgt daraus eine andere Reihenfolge. Nicht zuerst Content umschreiben, sondern zuerst prüfen, ob die Messung überhaupt Deutschland abbildet. Erst danach lässt sich entscheiden, ob ein Problem bei Technik, Evidenz, Positionierung oder Wiederholbarkeit liegt.
GEO in Deutschland 2026: Warum der Markt jetzt anders gemessen werden muss
GEO-Optimierung ist längst kein Randthema mehr. SISTRIX meldete für den 6. November 2026 AI Overviews bei 57,9 Prozent seines deutschen Keyword-Sets mit mehr als 100 Millionen Begriffen; die Marke von 50 Prozent war am 2. November überschritten worden. Das ist eine datierte Beobachtung aus einem konkreten Anbieter-Datensatz, keine Aussage über jede Suche in Deutschland. Für die Planung reicht sie dennoch: Klassische Rankings allein beschreiben einen wachsenden Teil der Sucherfahrung nicht mehr.
Auch die Klickwirkung braucht einen Zeitstempel. In einer SISTRIX-Auswertung vom Februar 2026 sank die durchschnittliche organische Klickwahrscheinlichkeit von 57 Prozent ohne AI Overview auf 33 Prozent mit AI Overview. Diese Werte dürfen nicht auf den heutigen Gesamtmarkt hochgerechnet werden. Sie zeigen, warum Teams neben Rankings auch Antworten, Quellen und Veränderungen beobachten müssen.
Ahrefs zeigt in der deutschen Keyword-Datenbank rund 2.100 monatliche Suchanfragen für „generative engine optimization“ und etwa 1.900 für „geo optimierung“. Beide SERPs enthalten eine AI Overview.
Die Lokalisierungslücke: Deutschsprachig ist nicht automatisch Deutschland-spezifisch
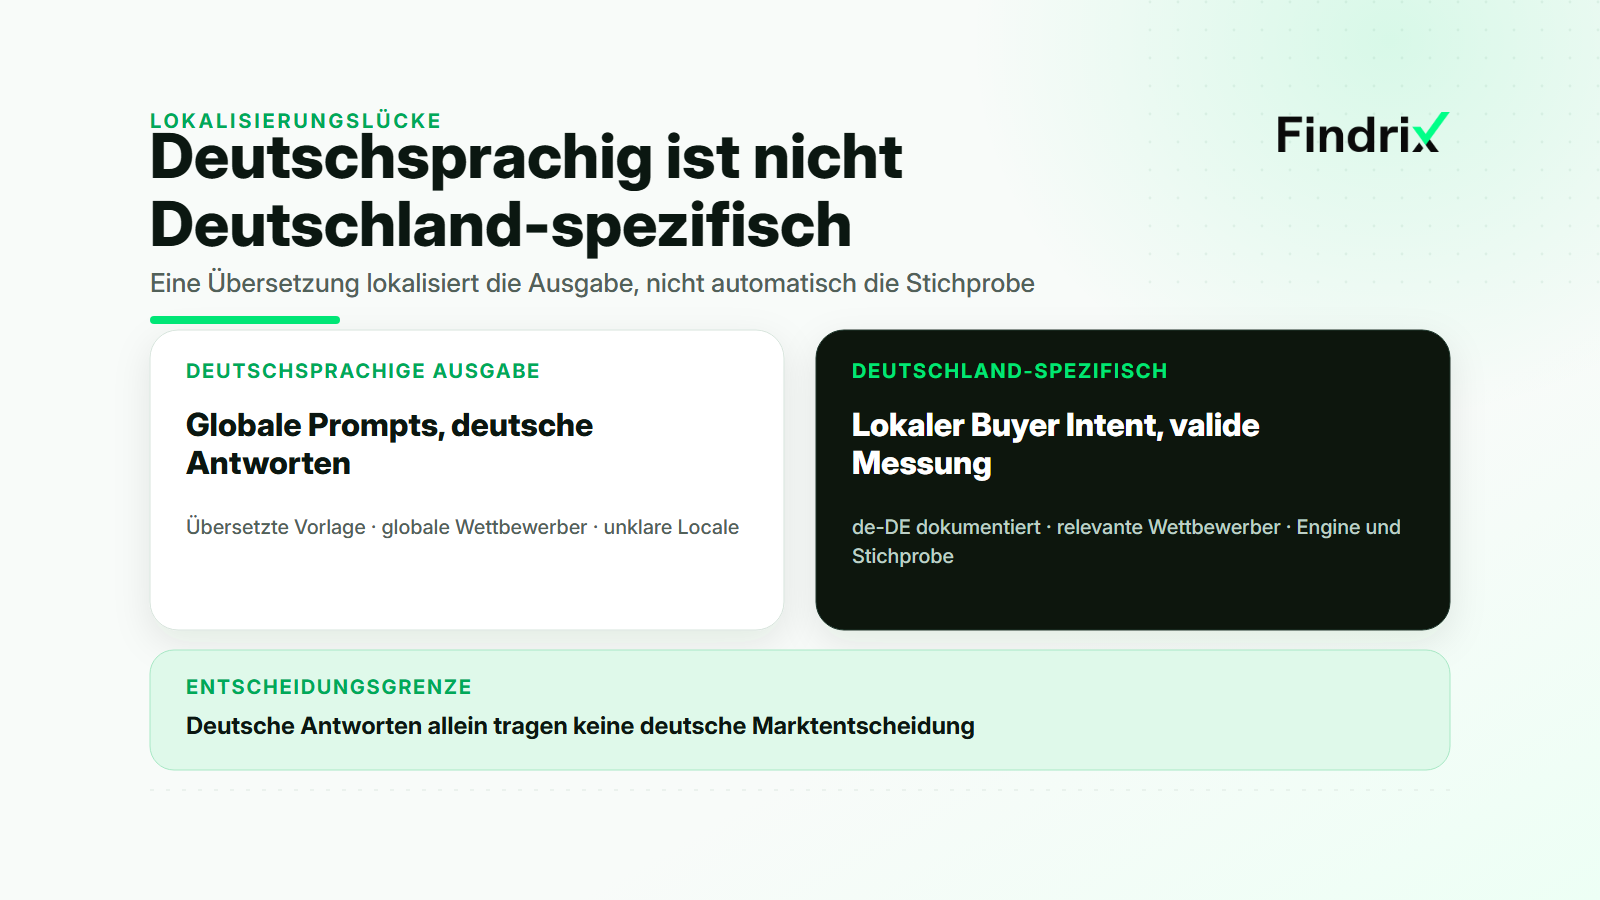
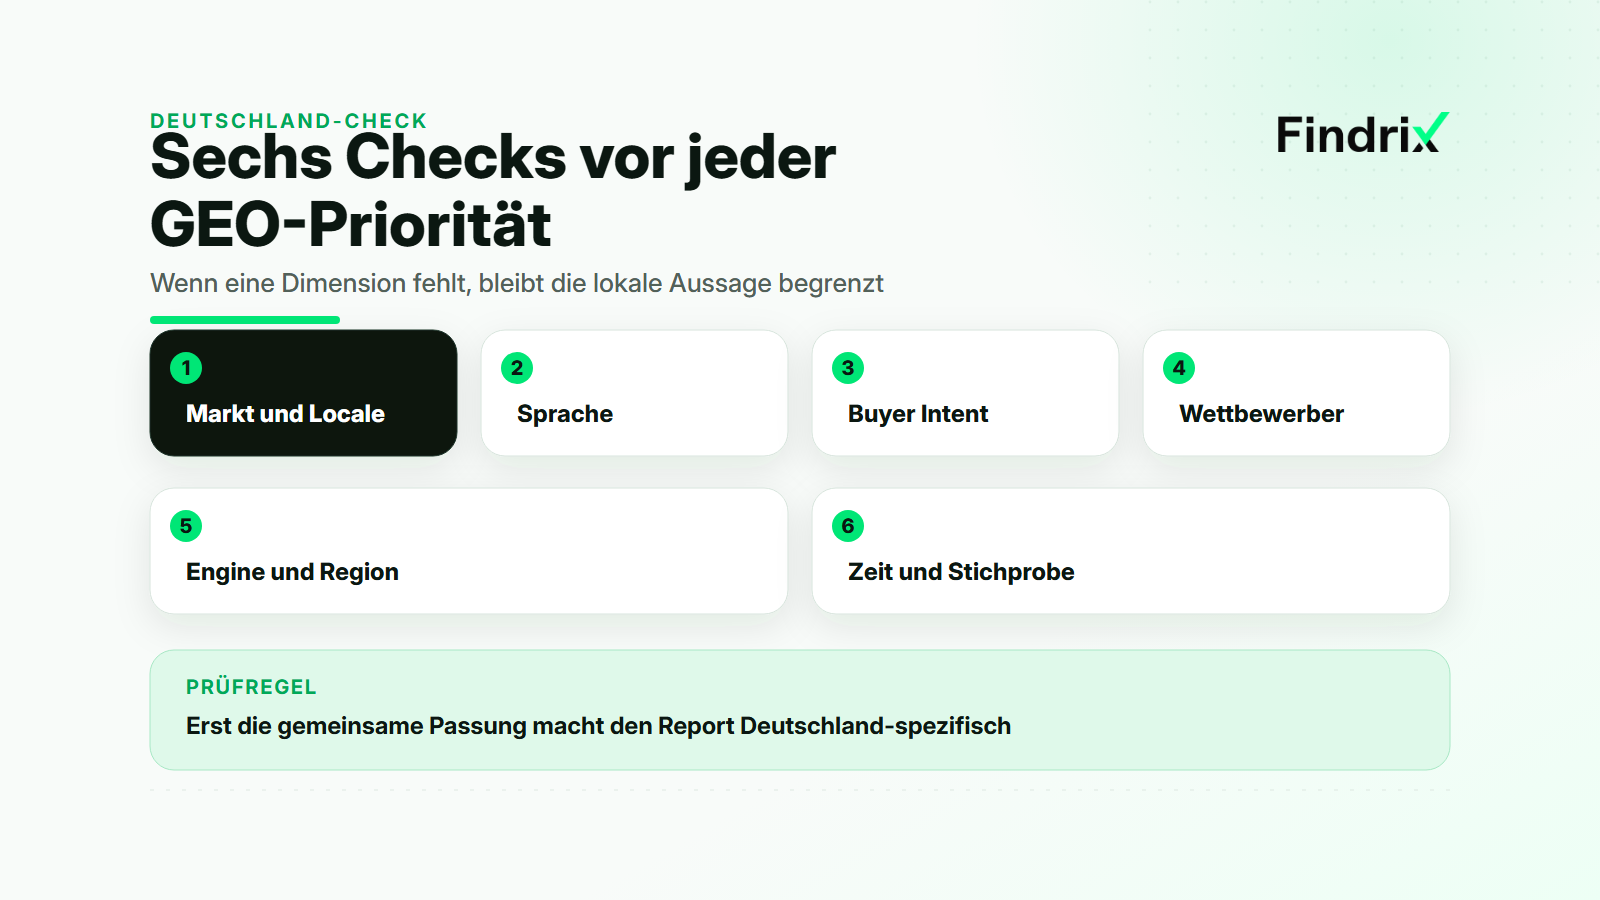
Eine Übersetzung lokalisiert die Oberfläche. Sie lokalisiert noch nicht die Stichprobe. Verwenden Sie deshalb vor jeder Priorisierung den Sechs-Punkte-Deutschland-Check:
| Dimension | Prüffrage | Warnsignal |
|---|---|---|
| Markt und Locale | Ist Deutschland beziehungsweise de-DE explizit gesetzt? | Globaler Pool mit deutscher Ausgabe |
| Sprache | Sind Prompts und erwartete Quellen sprachlich passend? | Übersetzte US-Prompts |
| Buyer Intent | Bilden die Fragen reale deutsche Kaufentscheidungen ab? | Nur generische Definitionen |
| Wettbewerber | Entspricht das Set dem deutschen Markt? | Nur globale Kategoriegrößen |
| Engine und Region | Sind Anbieter, Modell und Region dokumentiert? | Zusammengeführter Gesamtscore |
| Zeit und Stichprobe | Sind Datum, Wiederholungen und Methodenversion sichtbar? | Einzelner Lauf ohne Historie |
Practical example 1: ein hypothetisches B2B-SaaS-Unternehmen
Das Unternehmen kann 40 deutsche Prompts ausführen und trotzdem am Markt vorbeimessen, wenn die Fragen aus einer englischen Vorlage stammen und nur globale Wettbewerber enthalten. Der erste Korrekturschritt ist dann kein neuer Artikel. Das Team baut zuerst den Buyer-Question-Satz und das Wettbewerbsset neu auf, friert die Version ein und wiederholt dieselben Fragen über die ausgewählten Engines.
Globale Kategoriebegriffe dürfen als Vergleichsebene bleiben. Sie müssen nur getrennt von der lokalen Aussage ausgewiesen werden. So wird aus „Wir sind in deutschsprachigen Antworten sichtbar“ nicht versehentlich „Wir sind im deutschen Kaufprozess sichtbar“.
Drei Trends, die 2026 wirklich zählen
1. Wiederholung schlägt den Screenshot. In einer SISTRIX-Längsschnittanalyse wurden 82.619 Prompts über sechs Länder, drei Plattformen und 17 Wochen beobachtet. Die zitierten Domains drifteten von Woche zu Woche, und die Stabilität unterschied sich je Plattform. Ein gutes Ergebnis an einem Tag ist deshalb eine qualitative Beobachtung, aber noch kein belastbarer Trend.
2. Quellen und nächste Aktionen werden wichtiger als ein Gesamtscore. AI Visibility Tracking sollte zeigen, welche Antwort, Quelle oder Lücke eine Veränderung erzeugt. Sonst weiß das Team zwar, dass eine Kennzahl gefallen ist, aber nicht, ob es Zugänglichkeit, Belege, Positionierung oder nur normale Antwortvarianz untersuchen soll.
3. Die Methodik verändert die Prioritäten. Entity Matching, modelliertes AI-Volumen, neue Prompt-Sets oder andere Wettbewerber können eine Rangfolge verschieben, obwohl sich die zugrunde liegenden Antworten kaum verändert haben. Vergleichen Sie deshalb Rohantworten und Methodenversionen, nicht blind Prozentwerte aus verschiedenen Tools.
SISTRIX: deutsche Such- und AI-Overview-Daten einordnen
SISTRIX ansehenSISTRIX ist besonders nützlich, wenn ein Team den deutschen Suchmarkt, AI Overviews und Zitationsmuster in einem großen Keyword-Kontext einordnen möchte. Die aktuellen Deep Dives ergänzen priorisierte, datenbasierte Lückenanalysen.
Vor einer GEO-Entscheidung sollten jedoch vier Angaben sichtbar sein: Datum des Snapshots, Umfang und Auswahl des Keyword-Sets, betroffene Google-Oberfläche und Definition der ausgewiesenen Kennzahl. Die Daten liefern starken Marktkontext. Sie beweisen nicht automatisch, dass der eigene Buyer-Question-Satz repräsentativ ist.
Peec AI: von Sichtbarkeit zu Quellen, Crawling, Referrals und Actions
Peec AI ansehenPeec hat seinen operativen Layer 2026 unter anderem um Actions, Referral-Auswertungen, Crawler-Daten, Prompt-Sprachen und detailliertere Quellenansichten erweitert. Das ist relevant, wenn ein Team nicht nur Erwähnungen zählen, sondern aus einer Beobachtung eine Aufgabe ableiten möchte.
Die Prüffrage lautet: Kann das Tool den Befund von der Antwort über die Quelle bis zur verantwortlichen Aktion nachvollziehbar halten? Feature-Verfügbarkeit und Planlimits können sich ändern. Eine Produktdemo sollte deshalb mit dem eigenen deutschen Prompt- und Wettbewerberset erfolgen, nicht mit einem vorbereiteten globalen Beispiel.
Ahrefs Brand Radar: Entitäten und modelliertes AI-Volumen richtig lesen
Ahrefs Brand Radar ansehenAhrefs kombiniert in Brand Radar keyword-gebundene und semantisch modellierte Prompts. Neuere Entity-Matching- und AI-adjusted-volume-Layer können Discovery und Priorisierung verbessern. Sie sind besonders hilfreich, wenn ein Team zunächst herausfinden muss, welche Themen, Marken oder Quellen im Markt überhaupt auftauchen.
Modelliertes Volumen ist jedoch keine direkt beobachtete deutsche Nachfrage. Fragen Sie, welche Suchdaten in das Modell eingehen, wie Land und Sprache behandelt werden und ob ein Prioritätswechsel aus neuen Antworten oder aus einer Methodenanpassung stammt. Genau diese Trennung verhindert, dass ein Modellwert wie eine gemessene Reichweite berichtet wird.
Findrix: deutsche Buyer Questions zuerst als Baseline prüfen
Findrix ansehenBei Findrix beginnt die Aufgabe mit Buyer Questions. Das Team prüft, wie ChatGPT, Gemini und Google AI Mode Fragen zur eigenen Firma und zu Wettbewerbern beantworten, und untersucht anschließend Auslassungen, Vergleiche und Quellen.
Der Sechs-Punkte-Check bleibt dabei derselbe: deutscher Markt, passende Sprache, lokaler Buyer Intent, relevantes Wettbewerbsset, getrennte Engines sowie dokumentierte Zeit- und Stichprobengrenzen. Der Audit ist ein erster Ausgangspunkt. Er ist kein Beweis für einen repräsentativen Deutschland-Benchmark, besonders dann nicht, wenn die lokale Abdeckung noch dünn ist.
Was deutsche Teams zuerst optimieren sollten
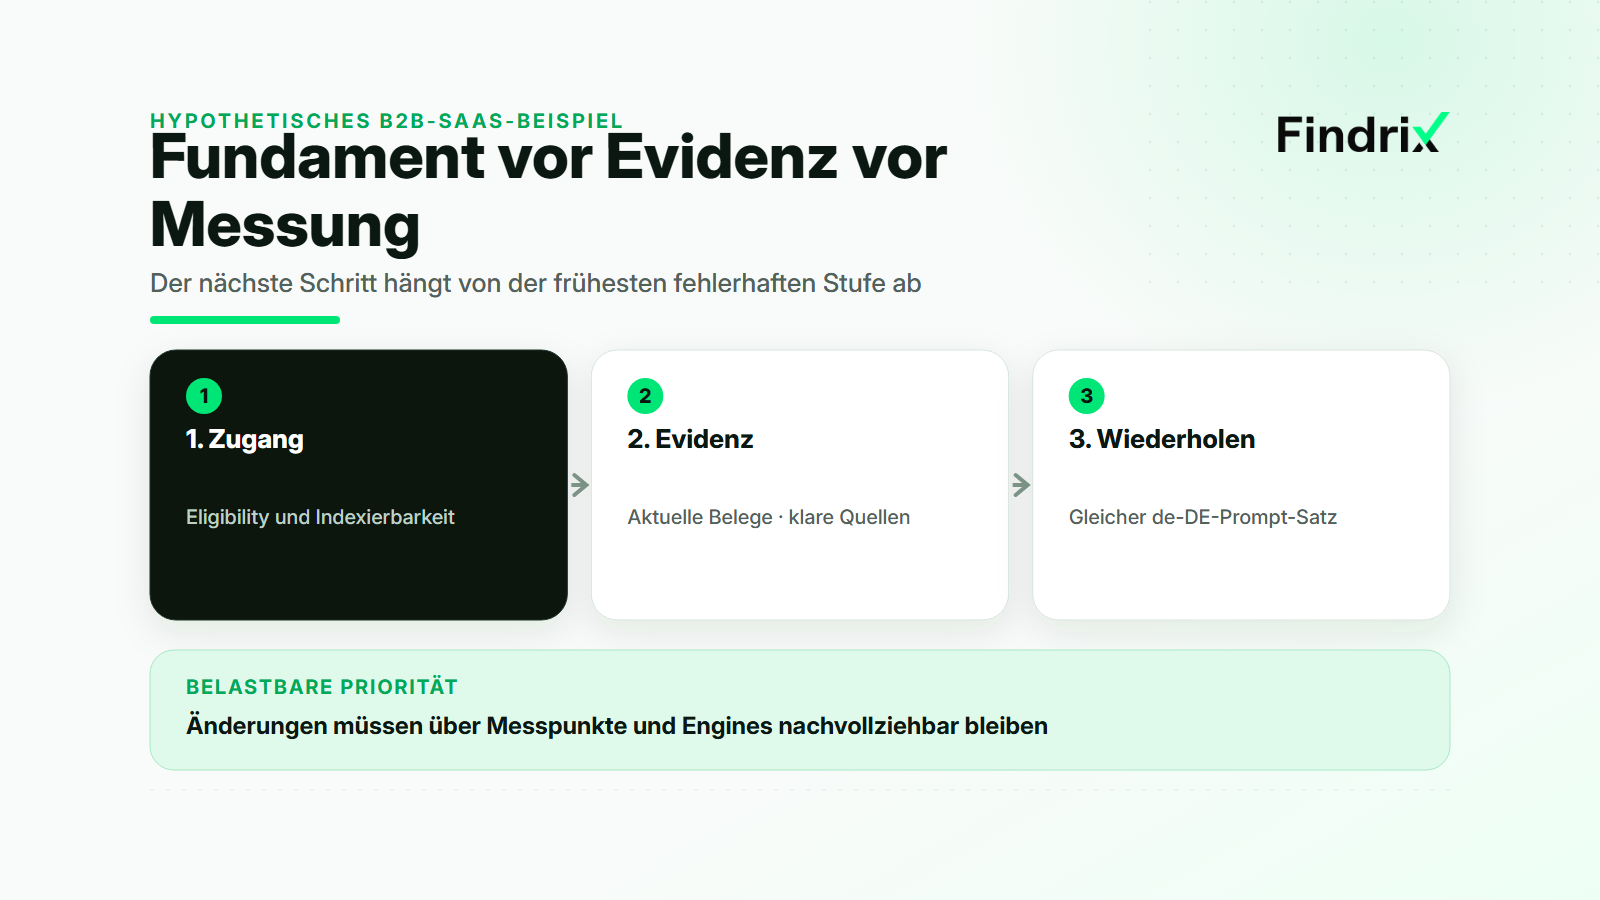
Die sinnvollste Reihenfolge für die nächsten 30 Tage besteht aus drei Schritten.
1. Zugang und Indexierbarkeit prüfen. Google verlangt für AI Overviews und AI Mode keine spezielle KI-Auszeichnung und keine besondere AI-Textdatei. Die normalen Search-Voraussetzungen und SEO-Grundlagen gelten weiter. Diese Aussage betrifft Google Search; andere Assistenten können andere Abrufwege verwenden. Prüfen Sie daher technische Zugänglichkeit je Oberfläche, bevor Sie Content-Taktiken diskutieren.
2. Verantwortbare Evidenz stärken. Eine DACH-Studie verglich 48.527 zitierte Seiten mit passenden nicht zitierten Seiten. Aktualität, menschliche Verantwortlichkeit und Struktur korrelierten mit Zitierungen; für llms.txt zeigte sich kein messbarer Vorteil. Das sind Korrelationen aus einem definierten Datensatz, keine universellen Kausalregeln. Sie rechtfertigen Investitionen in nachvollziehbare Autoren, aktuelle Belege und klare Quellen, nicht das Versprechen einer sicheren Zitation.
3. Denselben Messsatz erneut ausführen. Versionieren Sie Prompts, Wettbewerber, Engines und Methodik. Ändert sich ein Score nach einem Methodenwechsel, prüfen Sie zuerst die Rohantworten. Kleine Studien können sogar die Richtung eines Effekts umkehren; in der genannten DACH-Analyse stabilisierten sich einzelne Muster erst bei mehreren Tausend URLs.
Für unser hypothetisches SaaS-Team bedeutet das: zuerst technische Eligibility korrigieren, dann Belege für die wichtigsten Kaufargumente stärken und anschließend denselben de-DE-Prompt-Satz wiederholen. Erst wenn die Veränderung über Messpunkte und Engines nachvollziehbar bleibt, wird daraus eine belastbare Priorität.
Kostenlosen Findrix AI Visibility Audit starten
Kostenlosen Findrix AI Visibility Audit startenDer kostenlose Audit prüft 40 Buyer Questions über ChatGPT, Gemini und Google AI Mode; eine Kreditkarte ist nicht erforderlich. Nutzen Sie ihn, um eine erste Baseline zu erstellen: Wo wird die Marke genannt, welche Wettbewerber erscheinen, welche Belege werden zitiert und welche Antworten fehlen?
Dokumentieren Sie dabei von Anfang an die sechs Gültigkeitsdimensionen. Dann liefert der erste Lauf keine scheinbar endgültige Deutschland-Rangliste, sondern etwas Wertvolleres: eine überprüfbare Ausgangslage für die nächste Entscheidung.
Quellen
- Google Search Central: AI features and your website
- SISTRIX: deutsche AI-Overview-, GEO- und Citation-Drift-Analysen. Forschungs-URLs im internen Dossier.
- Peec AI: offizieller Produkt-Changelog. URL im internen Dossier.
- Ahrefs: Brand-Radar-Methodik und Produktupdates. URLs im internen Dossier.
- Findrix AI Visibility Audit